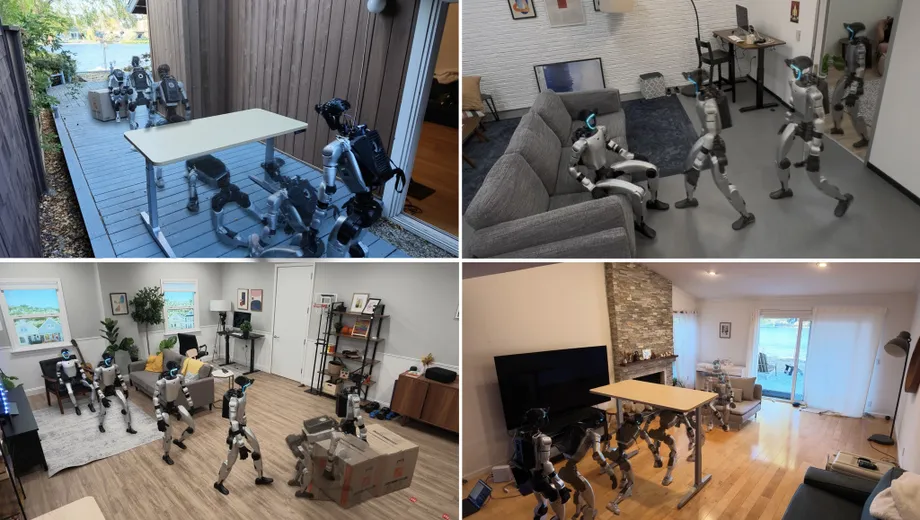
가상 주택에서 훈련한 로봇, 실제 공간에 도전
애플 연구진은 HALO 휴머노이드 제어 시스템이 사전에 스캔하거나 지도를 만들지 않은 실제 환경 6곳에서 360회 시험을 진행한 결과, 개별 신체 동작의 평균 성공률이 91%였다고 밝혔다. 유니트리 로보틱스의 G1에 탑재된 이 시스템은 시뮬레이션에서 학습한 내용을 활용해 낯선 공간을 이동하고, 가구에 앉고, 좁은 틈을 통과하고, 상자를 밀었다.
목차
연구 결과는 2026년 11월 4일 arXiv에 제출된 「시뮬레이션에서 학습한 지각 기반 휴머노이드 동작」에 실렸다. 애플 연구팀의 논문은 컴퓨터로 생성한 주택 환경 1,000곳에서 약 300시간 분량의 합성 사례를 활용해 훈련한 뒤, 시스템을 실제 로봇에 바로 적용했다고 설명한다.
여러 동작을 잇는 과제는 더 어려웠다. 별도의 실제 환경에서 HALO는 동작 조합 3종을 각각 10회씩 시도해 평균 성공률 70%를 기록했다. 장애물 아래로 몸을 숙여 통과하고, 목표물에 다가간 뒤 상자를 미는 동작은 10회 중 5회 성공했다.
실용적인 진전은 요청을 이해하는 기능과 낯선 가구가 놓인 공간에서 전신을 움직이는 기능을 연결한 데 있다. 의자에 앉으라는 명령을 수행하려면 로봇은 좌석을 식별하고, 이동 경로를 찾고, 몸의 위치를 맞춘 뒤, 몸을 낮추는 동안 균형을 유지해야 한다. HALO는 이러한 역할을 서로 협력하는 세 가지 제어 계층으로 나눈다.
저자는 시위안 후, 아불리케무 아부두웨일리, 웨 멍, 스펑 류, 쿠엔틴 르부테, 천천, 마티아스 뮐러, 블라들렌 콜툰이며, 모두 소속 기관으로 애플을 명시했다. 연구진은 데이터 생성, 훈련, 배포를 다루는 코드도 공개했다. 여기에는 시뮬레이션과 실제 로봇에서의 과제 계획, 동작 생성, 동작 추적 기능이 포함된다.
성공률 91%가 의미하는 것
개별 동작 6종의 성공률은 서로 달랐다. 몸을 숙이는 동작의 성공률이 가장 높았고, 시험한 동작 중 앉기가 가장 낮았다.
- 지정된 물체로 이동: 92%.
- 가구에 앉기: 85%.
- 반쯤 열린 문 통과: 93%.
- 장애물 아래로 몸을 숙여 통과: 100%.
- 장애물 아래로 기어 통과: 90%.
- 상자 밀기: 88%.
몸을 숙이는 동작과 앉기 사이에는 15%포인트 차이가 났다. 앉으려면 알맞은 위치에 도달하는 것만으로는 부족하다. 로봇은 가구에 몸을 맞추고 체중을 좌석에 실어야 한다. 이 과정에는 시각적 이해 능력과 물리적 제어 능력이 모두 필요하다.
평가에 사용된 환경 6곳은 모두 HALO에 낯선 공간이었다. 연구진은 사전에 환경을 스캔하지 않았고 훈련에도 사용하지 않았다. 논문은 이를 제로샷 전이라고 부른다. 각 장소에 맞춰 추가 훈련을 하지 않고 시뮬레이션 훈련을 실제 환경으로 옮겼다는 뜻이다.
시연 영상에는 G1이 사람을 따라가고, 소파에 앉고, 반쯤 열린 문을 옆으로 통과하며, 테이블 아래로 몸을 숙이거나 기어가는 모습도 담겼다. 이 동작들은 시스템이 목적지를 향해 단순히 걷는 데 그치지 않고 주변 공간에 맞춰 자세를 조정하는 방식을 보여준다.
긴 지시가 더 어려운 이유
HALO가 여러 과제를 조합해 수행한 세 가지 시험에서는 결과 편차가 더 컸다. 문을 통과한 뒤 목표물로 이동하는 동작은 10회 모두 성공했다. 몸을 숙인 뒤 앉는 동작은 10회 중 6회 성공했다. 몸을 숙이고 목표물에 다가간 뒤 상자를 미는 동작은 5회 성공했다.
세 과제를 합치면 30회 중 21회 성공해 성공률은 70%다. 개별 과제 평균보다 21%포인트 낮지만, 연속 동작 시험은 다른 환경에서 더 적은 횟수로 진행됐다.
동작을 연결하면 문제가 생길 기회가 늘어난다. 한 동작의 결과가 다음 동작의 시작 위치가 되기 때문이다. 예를 들어 장애물 아래에서 빠져나온 뒤에는 로봇이 목표물에 다가가 다음 동작을 이어갈 수 있는 위치에 있어야 한다.
HALO는 시각적 확인을 통해 이 문제에 대응한다. 계획 모듈은 로봇 시점의 영상을 살펴 현재 동작이 성공했는지 판단하고, 다음 단계로 넘어갈지 다시 시도할지 결정한다. 이번 결과는 유용한 동작들을 연결하는 일이 각각의 동작을 따로 수행하는 것보다 더 까다로운 문제임을 보여준다.
세 계층이 요청을 동작으로 바꾼다
최상위 제어 계층은 과제 계획을 맡는다. 이미지와 단어를 모두 처리하는 AI의 한 종류인 비전·언어 모델을 사용해 요청과 카메라에 비친 장면을 함께 해석한다. 기본 모델은 Qwen3.6-35B-A3B이며, 로봇이 싣고 다니는 맥 미니에서 로컬로 실행된다.
계획 모듈은 2초마다 작동한다. 누군가 좌석을 특정하지 않고 앉으라고 지시하면 로봇은 시야에 들어온 물체 중 적절한 것을 골라야 한다. 의자까지 가는 길에 테이블이 놓여 있다면 장애물 아래로 몸을 숙이고, 의자에 다가가 앉는 식으로 요청을 더 작은 동작으로 나눌 수 있다.
중간 계층은 각 세부 과제를 동작 계획으로 바꾼다. 훈련 중 인코더 매개변수를 고정한 Qwen3.5-2B와 전신 동작을 생성하는 디퓨전 트랜스포머 디코더를 결합한다. 인코더는 이미지와 지시를 동작 모델이 활용할 수 있는 표현으로 바꾸고, 디코더는 계획된 자세를 생성한다.
이 계층은 약 5초 앞을 내다보며 초당 약 3회 계획을 다시 세운다. 따라서 주변을 확인하지 않은 채 5초 분량의 동작을 한 번에 실행하는 대신, 새로 들어오는 카메라 정보를 바탕으로 의도한 움직임을 계속 갱신한다.
모션 트래커라고 불리는 최하위 계층은 이러한 계획을 초당 50회 관절 명령으로 바꾼다. 깊이 이미지와 로봇 자체의 위치 및 움직임 정보를 결합해 균형, 접촉, 모터 한계를 고려하면서 계획을 따르도록 돕는다.
G1에 실린 맥 미니
실제 장비에서는 M4 Pro 칩과 통합 메모리 64GB를 탑재한 맥 미니를 보호 케이스에 넣어 G1 등에 장착했다. 이 컴퓨터는 계산량이 많은 과제 계획 및 동작 생성 모델을 실행한다. G1 자체의 탑재 프로세서는 모션 트래커를 구동한다.
맞춤형 헤드 마운트에는 OAK-1W 카메라가 달렸다. 카메라의 컬러 영상은 해상도 1280×800픽셀, 초당 30프레임으로 촬영되며 시야각은 120도다. 넓은 시야는 몸을 움직이는 동안 주변 가구와 통로를 관찰하는 데 도움이 된다.
로봇은 외부에 연결된 케이블 없이 작동하며, 소프트웨어 구성 요소는 메시징 시스템인 ZeroMQ를 통해 통신한다. 기본 로컬 구성은 인터넷 연결 없이 사용할 수 있다. 설정에 따라 HALO가 애플리케이션 프로그래밍 인터페이스를 통해 클라우드 모델을 호출하는 것도 가능하다.
컴퓨팅 작업의 분담은 제어 계층 구조에 맞춰져 있다. 요청을 이해하는 과정은 비교적 드물게 수행해도 되지만, 움직이는 로봇의 안정성을 유지하려면 훨씬 더 자주 갱신해야 한다. 모션 생성기가 새 계획을 계산하는 동안 트래커는 현재 계획을 계속 실행하므로 모델이 계산할 때마다 로봇이 멈추지 않는다.
가상 주택 1,000곳에서 훈련 사례를 만드는 방법
HALO의 훈련 과정은 특정한 데이터 부족 문제를 해결한다. 휴머노이드가 무엇을 보고, 어떤 지시를 받으며, 전신을 어떻게 움직여야 하는지 연결해 주는 사례가 부족하다는 점이다. 일반 영상에는 동작이 담겨 있지만, 이 시스템을 훈련하려면 영상에 지시와 상세한 로봇 동작 정보가 함께 있어야 한다.
연구진은 사람이 직접 조작하거나 착용형 기록 장비를 사용해 시연 사례를 수집하는 일부 방법에 필요한 시간을 다음과 같이 설명한다.
사람이 모든 에피소드를 직접 수행해야 하므로, 데이터 한 시간분을 모으려면 사람의 시간도 최소 한 시간이 든다.
HALO는 대신 시뮬레이션에서 서로 짝을 이룬 사례를 만든다. 먼저 과제를 여러 동작 구간으로 나눈다. 예를 들어 안락의자에 앉는 동작에는 앞으로 걷기, 돌아서기, 좌석에 몸을 낮추기 등이 포함될 수 있다. 텍스트 프롬프트, 경로상의 경유 지점, 주요 자세를 동작 생성 모델인 키모도(Kimodo)에 입력한다.
이후 자동화된 기하학적 검사를 통해 발이 미끄러지는 현상, 바닥을 뚫고 지나가는 몸, 갑작스러운 도약, 관절 가동 범위 초과 등의 문제를 기준으로 후보 동작에 점수를 매긴다. 절차에 따라 가장 우수한 후보를 남긴 뒤 가상 공간에 배치한다.
절차적 장면 생성기 인피니젠(Infinigen)은 거실, 사무실, 침실 등을 포함해 가구와 배치가 다양한 환경 1,000곳을 만든다. 시스템은 로봇의 계획된 동작과 목표 물체가 주변 가구와 충돌하지 않고 들어맞는 배치를 찾는다.
이어 시뮬레이터가 물리적 장비와 같은 설정의 어안 카메라를 사용해 로봇이 동작을 수행할 때 보게 될 장면을 렌더링한다. 조명, 노출, 색상, 대비, 흐림, 센서 노이즈를 바꿔 이미지의 다양성을 높인다. 이렇게 만들어진 각 사례에는 지시, 카메라 화면, 해당 신체 동작이 연결된다.
컴퓨팅 비용과 사람의 작업
주요 훈련 데이터 집합을 만드는 데는 엔비디아 H100 그래픽 처리 장치 250개를 사용해 약 48시간이 걸렸다. GPU라고도 불리는 이 프로세서는 많은 계산을 병렬로 처리해 대량의 시뮬레이션 데이터를 한꺼번에 생성할 수 있다.
동작 생성기는 엔비디아 B200 GPU 64개를 사용해 모방 학습 방식으로 훈련했다. 모방 학습은 모델이 예시 행동을 재현하도록 학습시키는 방법이다. 모션 트래커는 H100 GPU 4개로 훈련했으며, 이 과정에는 강화 학습과 정책 증류를 결합했다.
강화 학습은 시도와 수행 결과에 대한 피드백을 통해 제어기를 훈련한다. 정책 증류는 학습된 동작을 다른 모델로 옮기는 방법이다. HALO에서는 이 방법들이 트래커가 계획된 자세를 실제 로봇이 수행할 수 있는 움직임으로 바꾸는 데 도움을 준다.
사람은 여전히 과정의 일부를 직접 설계한다. 새로운 실제 과제를 추가하려면 프롬프트를 작성하고 주요 자세를 설계해야 하며, 일부 동작은 사람의 영상이나 모션 캡처 자료를 활용한다. 과제 설명과 제약 조건을 만들어 두면 파이프라인은 이를 여러 가상 공간에서 재사용할 수 있다.
따라서 달라진 점은 시연 사례를 확장하는 방식이다. 사람이 모든 에피소드를 직접 수행하는 대신, HALO는 컴퓨팅 자원을 투입해 과제의 다양한 사례를 생성하고 검증한다.
시각 정보만으로는 접촉 문제를 해결하기 어렵다
연구진에 따르면 HALO는 현재 주로 시각 정보에 의존하며 접촉을 직접 감지하지 못한다. 물체가 카메라 시야에서 벗어나거나 다른 물체에 가려지면, 상당한 물리적 접촉이 필요한 과제의 수행 능력이 떨어질 수 있다.
상자 밀기는 이 점이 중요한 이유를 보여준다. 상자가 움직이는 동안 로봇도 상자와의 위치 관계를 제대로 유지해야 한다. 카메라는 눈에 보이는 위치 정보를 제공하지만, 촉각 센서는 시야가 가려져도 유용한 접촉 정보를 제공할 수 있다.
연구진은 촉각 센서를 향후 연구 방향 중 하나로 꼽았지만, 도입 시점은 제시하지 않았다. 이번 결과는 과제의 한계를 구체적으로 보여준다. HALO는 낯선 공간에서 시각 정보에 따라 여러 동작을 수행할 수 있지만, 긴 동작의 연속 수행과 접촉을 수반하는 상호작용은 여전히 안정성이 낮다.
이번 연구가 달라지게 하는 것
애플의 연구는 데이터 생성, 언어 기반 계획, 물리적 제어를 하나의 시스템으로 통합해, 휴머노이드가 이전에 접한 적 없는 공간에서 작동하도록 했다. 가장 두드러진 성과는 가상 환경 1,000곳에서 훈련한 시스템을 실제 시험 장소 6곳에 대한 사전 지도 작성 없이 실제 시험 360회에 적용한 것이다.
공개된 코드는 시뮬레이션과 실제 하드웨어를 아우르는 후속 연구에 활용할 수 있다. 훈련 사례 생성 도구뿐 아니라 동작을 생성하고 추적하며 조율하는 데 필요한 모델과 소프트웨어도 포함한다.
로봇에게 앉거나 상자를 옮기라고 요청하는 사람이 기대하는 신뢰성은 전체 과정이 함께 작동하는지에 달려 있다. 적절한 물체를 알아보고, 물체에 다가가 접촉한 뒤 동작을 마쳐야 한다. HALO의 개별 과제 결과는 이 과정에서 진전이 있음을 보여준다. 연속 동작 결과는 여러 행동을 같은 수준의 일관성으로 연결하려면 어느 부분에 추가 연구가 필요한지 드러낸다.
핵심 내용
- 애플 연구진은 「시뮬레이션에서 학습한 지각 기반 휴머노이드 동작」을 2026년 11월 4일 arXiv에 제출했다.
- HALO는 낯설고 지도가 없는 실제 환경 6곳에서 개별 과제 시험 360회를 진행해 평균 성공률 91%를 기록했다.
- 다른 실제 환경에서 과제 조합 3종은 30회 시험에서 평균 성공률 70%를 보였다.
- 이 시스템은 과제 계획, 동작 생성, 초당 50회 관절 명령을 내리는 트래커를 결합한다.
- 훈련에는 생성 환경 1,000곳에서 만든 약 300시간 분량의 합성 사례가 사용됐다.
- 유니트리 G1에 장착된 맥 미니는 인터넷 연결 없이 로컬에서 작동하도록 지원한다.
- 훈련 과정에는 사람의 과제 설계가 여전히 필요하며, 제한적인 접촉 감지 능력도 약점으로 남아 있다.