저렴한 경쟁 제품을 겨냥한 중국의 소형 AI 컴퓨터
Sipeed는 중국 반도체 업체 Axera의 AX8860P를 탑재한 128GB 메모리 MaixStation 컴퓨터의 가격을 약 3,999달러로 책정하는 방안을 추진하고 있다. 제품 크기는 11×11×3cm에 불과하며, 일반적인 소비전력 40와트로 대규모 AI 모델을 로컬에서 실행할 수 있다고 한다. 경쟁 제품으로는 128GB 모델 가격이 약 6,950달러인 Nvidia의 소형 AI 시스템 DGX Spark를 겨냥했다.
목차
Axera는 2026년 10월 13일 상하이에서 열린 산업 전시회에서 칩을 공개했고, Sipeed도 같은 자리에서 MaixStation을 선보였다. 당시 내세운 성능은 눈길을 끌었다. 매개변수 270억 개의 Qwen 모델을 실행할 때 DGX Spark보다 프롬프트 처리 속도는 25%, 답변 생성 속도는 30% 빠르며, 가격은 대략 절반이라는 설명이었다.
이후 Sipeed의 MaixStation 제품 페이지에 더 자세한 내용이 공개됐다. Qwen3.8-27B의 프롬프트 처리 속도는 초당 592~677토큰, 답변 생성 속도는 초당 6~7토큰으로 제시됐다. 이 수치는 발표 당시 알려진 범위보다 낮다. 공식 출시 계획에 따르면 킥스타터 캠페인은 2026년 말 시작될 예정이다.
제품의 장점은 분명하다. 소형 컴퓨터에 대용량 메모리를 갖추면 개발자와 사무실, 개인 사용자가 클라우드 컴퓨팅을 빌리거나 그래픽카드를 여러 장 구매하지 않고도 성능이 뛰어난 모델을 실행할 수 있다. 다만 실제 구매 판단은 칩 사양뿐 아니라 최종 소프트웨어, 측정된 성능, 배송 일정에도 달려 있다.
AX8860P에 담긴 Axera의 기술
AX8860 제품군은 6나노미터 공정으로 제조되며 Arm Cortex-A55 CPU 코어 16개와 전용 신경망처리장치(NPU)를 결합했다. NPU는 AI 모델에서 반복적으로 수행되는 계산을 처리하도록 설계된 프로세서다. Axera와 Sipeed는 FP4 기준 최대 초당 256조 회 연산, 즉 256 TOPS의 성능을 제시한다.
FP4는 숫자 값을 4비트 정밀도로 저장하는 방식이다. 비트 수를 줄이면 모델에 필요한 메모리를 줄이고 계산 속도를 높일 수 있지만, 모델과 소프트웨어가 해당 형식을 지원해야 한다. Axera가 제시한 수치는 희소성이라는 기법으로 일부 값을 건너뛸 수 있다고 가정한 계산이 아니라, 밀집 연산 기준이다.
칩은 PCIe 5.0과 256비트 폭의 메모리 인터페이스를 지원한다. Sipeed는 LPDDR5X-8533 메모리, 모듈당 최대 128GB 용량, 초당 273GB의 대역폭을 제시했다. Maix-V 모듈의 크기는 78×78mm이며 LPCAMM2 커넥터를 사용한다.
Cortex-A55 코어는 운영체제와 보조 작업을 처리하고, NPU는 주된 AI 작업을 맡도록 설계됐다. Nvidia DGX Spark에는 더 강력한 Cortex-X925 코어를 포함해 Arm 코어 20개가 탑재됐다. 경쟁 제품인 AMD Ryzen AI Halo는 Zen 5 CPU를 사용한다. 따라서 AI 추론과 상당한 규모의 일반 컴퓨팅 작업을 함께 수행하려는 사용자는 가속기만 비교해서는 안 된다.
주목할 지표는 TOPS보다 128GB 메모리
언어 모델은 학습 과정에서 습득한 정보를 담은 숫자 가중치와 요청에 답하는 동안 생성되는 작업 데이터를 메모리에 저장해야 한다. 가속기 성능이 높더라도 메모리가 부족하면 모델을 여러 장치에 나눠 올리거나 속도가 느린 저장장치를 통해 불러와야 할 수 있다.
MaixStation의 128GB 구성은 더 큰 DGX Spark와 같은 메모리 용량대에 속한다. 두 제품 모두 메모리 대역폭은 초당 273GB다. AMD Ryzen AI Halo 제품군에는 초당 약 256GB 대역폭의 128GB 구성과, 초당 273GB 대역폭을 제공하는 192GB 고가 모델이 있다.
메모리 용량은 얼마나 많은 데이터를 담을 수 있는지를 결정하고, 대역폭은 정보가 프로세서로 얼마나 빠르게 이동하는지를 좌우한다. 밀집 언어 모델이 일반적으로 답변을 생성할 때는 새 토큰 하나를 만들기 위해 방대한 모델 데이터를 읽어야 한다. 토큰은 텍스트를 이루는 작은 단위로, 단어 하나일 수도 있고 단어의 일부일 수도 있다.
이에 Sipeed는 메모리를 효율적으로 활용하면 256 TOPS 프로세서도 Nvidia가 더 크게 내세우는 연산 성능에 맞설 수 있다고 주장한다. DGX Spark의 FP4 성능은 희소성 적용 기준으로 약 1,000 TOPS이며, 밀집 FP4 성능은 초당 약 500조 회 연산이다. 실제 애플리케이션 속도는 소프트웨어가 하드웨어를 얼마나 효율적으로 활용하는지에도 좌우된다.
공식 벤치마크 페이지가 보여주는 더 제한적인 성능
Sipeed는 테스트를 프리필(prefill)과 디코드(decode)로 나눠 공개한다. 프리필은 모델이 사용자 프롬프트를 처리하는 단계이고, 디코드는 답변을 생성하는 단계다. 프리필이 빠르면 특히 긴 문서를 입력했을 때 답변이 시작되기까지 기다리는 시간을 줄일 수 있다. 디코드가 빠르면 생성이 시작된 뒤 답변이 더 빠르게 나타난다.
밀집 FP4 기준 Qwen3.8-27B에서 공식 페이지는 MaixStation의 프리필 속도를 초당 592~677토큰, DGX Spark를 550토큰으로 제시한다. 약 8~23% 앞서는 셈이다. MaixStation의 디코드 속도는 초당 6~7토큰으로 공개됐지만, 공식 차트의 제공된 자료에는 이 모델의 DGX Spark 디코드 기준 수치가 없다.
전문가 혼합(MoE) 모델인 Qwen3.6-35B-A3B의 경우 Sipeed는 프리필 속도를 초당 2,664~3,256토큰으로 제시했다. DGX Spark는 2,368토큰이다. 계산상 격차는 약 13~38%다. 디코드 속도는 MaixStation이 초당 34~37토큰, DGX Spark가 34토큰으로, 동률에서 약 9% 우위까지 차이가 난다.
전문가 혼합 모델은 토큰을 생성할 때마다 신경망의 일부만 활성화한다. 이 때문에 전체 매개변수 수가 비슷한 밀집 모델보다 생성 속도가 훨씬 높을 수 있다. 두 모델 유형은 토큰당 필요한 연산량이 다르다.
Sipeed는 공개된 결과를 현재 측정한 보수적인 수치라고 설명하며, AX8860P는 아직 튜닝 중이라고 밝혔다. 차트는 다중 토큰 예측(MTP)을 끈 상태에서 FP4를 사용했다고 명시한다. MTP는 여러 개의 다음 토큰을 한 번에 제안해 생성을 가속하는 기법이다.
초기 속도 주장은 신중한 비교가 필요
Sipeed가 앞서 공개한 벤치마크 범위는 더 높았다. Qwen3.8-27B 프리필은 초당 1,400~1,600토큰, 디코드는 15~17토큰으로, DGX Spark의 기준치인 각각 1,300토큰과 13토큰을 웃돌았다. 전문가 혼합 모델의 경우 프리필은 초당 6,300~7,700토큰, 디코드는 80~88토큰으로 제시됐다. DGX Spark의 기준치는 각각 5,600토큰과 80토큰이었다. Sipeed는 이후 비교 자료에서 두 단계 모두 MaixStation이 약 10% 앞선다고 밝혔으며, 더 큰 격차를 보인 후속 테스트는 공식 결과가 아니라고 설명했다.
공식 페이지의 절대 속도가 낮아진 만큼 테스트 조건이 특히 중요해졌다. 프롬프트 길이, 동시에 처리한 요청 수, 숫자 형식, 런타임 소프트웨어와 드라이버 버전은 모두 결과를 바꿀 수 있다. 보도에서 인용한 독립 DGX Spark 테스트에서는 추측 디코딩을 사용하지 않았을 때 Qwen3.8-27B의 생성 속도가 초당 약 11.5~11.6토큰에 달했다. 프리필 속도는 소프트웨어에 따라 초당 840~1,900토큰이었다.
간단한 메모리 계산을 보면 초당 17토큰이라는 초기 주장이 왜 주목받았는지 알 수 있다. 실행 중인 모델의 메모리 사용량이 약 16GB라면 초당 273GB를 16GB로 나눌 때 다른 메모리 트래픽을 고려하기 전 기준으로 초당 약 17토큰이 나온다. 이 속도를 내려면 공표된 대역폭을 매우 높은 수준으로 활용해야 한다.
여기서는 모델이 실제로 차지하는 메모리 크기가 중요하다. 매개변수 270억 개에 4비트를 곱하면 가중치만 약 13.5GB가 필요하고, 숫자 스케일링 데이터와 기타 저장 공간을 더하면 실제 작업 크기는 커질 수 있다. 상세하고 반복 가능한 테스트가 공개되면 구매자는 속도 수치를 구체적인 모델 구성과 연결해 판단할 수 있다.
표준 저장장치를 갖춘 초소형 컴퓨터
MaixStation의 공개 크기를 기준으로 계산하면 부피는 363㎤다. Sipeed는 DGX Spark의 부피인 1,125㎤와 비교해 제품 크기가 약 3분의 1이라고 설명한다. 회사에 따르면 65와트 정격의 적합한 보조배터리를 사용하면 USB-C로 전원을 공급할 수 있다.
공식 페이지에 기재된 일반적인 소비전력은 MaixStation이 40와트, DGX Spark가 120와트다. 이는 Sipeed가 제시한 일반적인 부하 기준이다. AX8860에 관한 초기 보도자료도 전용 모듈의 소비전력을 40와트로 명시했는데, 향후 테스트에서는 전력 측정 범위가 어디까지인지도 확인할 필요가 있다.
연결 단자는 10G SFP+ 네트워킹, USB-C, MCIO 8i 커넥터와 SSD용 표준 M.2 2280 슬롯을 포함한다. 표준 저장장치 형식을 사용해 익숙한 방식으로 저장 공간을 추가할 수 있다. 모델 파일은 수백 기가바이트에 이르는 경우도 있어 공간을 빠르게 차지할 수 있다.
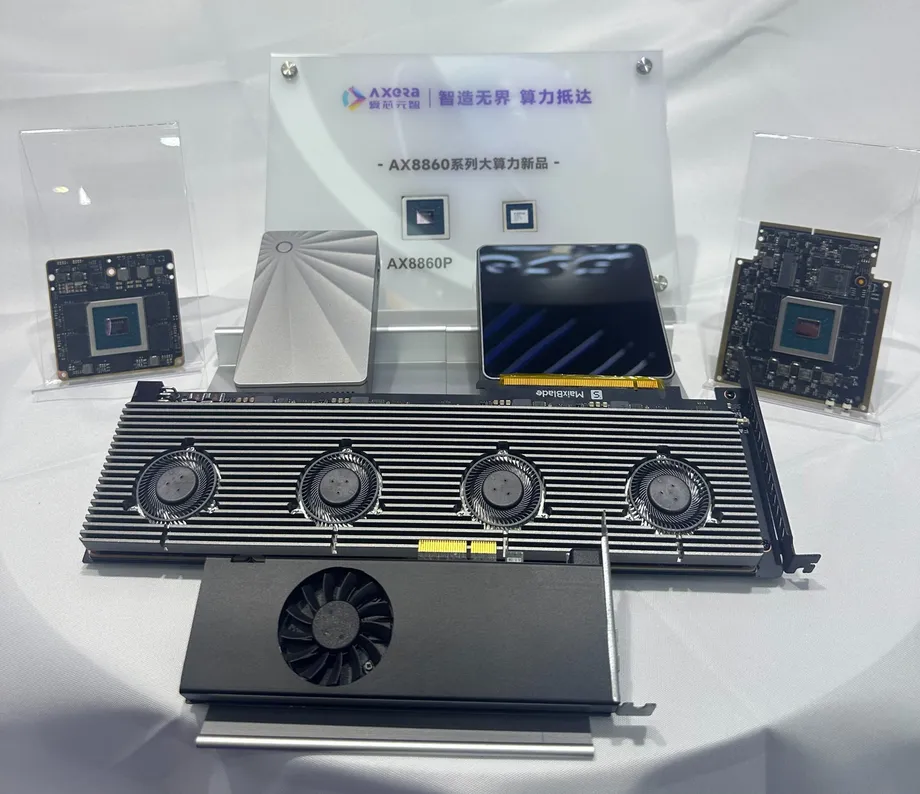
Axera의 하드웨어 계획은 소형 데스크톱 제품에 그치지 않는다. 모듈, 칩 1개를 탑재한 PCIe 카드, 칩 4개와 팬 4개, 표준 8핀 전원 커넥터를 갖춘 카드가 설계에 포함됐다. Sipeed는 MaixStation Pro와 MaixBlade가 512GB 이상 메모리를 제공하는 구성과 연결된다고 밝혔다.
칩을 추가하면 용량은 커지지만 확장 성능은 아직 주장 단계
Sipeed는 칩 간 연결 속도가 초당 256기가비트이며 초당 384기가비트까지 확장 가능한 연결을 이용해 MaixStation 노드를 외부 스위치 없이 최대 8대까지 연결할 수 있다고 밝혔다. DGX Spark는 시스템 연결에 초당 200기가비트 연결을 사용하며, Spark 4대를 구성하려면 외부 스위치가 필요하다.
기가비트와 기가바이트의 차이를 유의해야 한다. 초당 256기가비트 연결은 오버헤드를 고려하기 전 기준으로 초당 32기가바이트에 해당한다. 초당 273기가바이트의 메모리 대역폭은 각 컴퓨터 내부에서 이뤄지는 별도의 훨씬 빠른 연결을 가리킨다.
Axera는 칩 2개를 결합하면 512 TOPS, 4개를 사용하면 1,024 TOPS를 제공한다고 제시하며 약 80%의 확장 효율을 주장한다. 4칩 구성의 확장 성능은 실험실 시뮬레이션 결과다. 모델을 여러 프로세서에 나누면 통신과 동기화 작업도 필요하므로, 애플리케이션 속도는 각 프로세서의 최대 연산 성능을 단순히 더한 값으로 결정되지 않는다.
Axera의 로드맵에는 최대 500 TOPS의 AX8950과 700 TOPS를 넘는 AX8970이 포함됐다. 이들 예정 칩은 향후 업그레이드 경로가 될 수 있지만, 당장 MaixStation의 경쟁력은 AX8860P와 소프트웨어에 달려 있다.
일상적인 사용 경험을 좌우할 소프트웨어
Sipeed는 Linux 6.18 기반 Debian 13과 함께 vLLM, SGLang, PyTorch, llama.cpp, Ollama 지원을 제시한다. 이들 도구를 이용하면 모델을 불러오고 요청을 처리하며 AI 애플리케이션을 하드웨어에 연결할 수 있다. 회사는 OpenAI 및 Anthropic과 호환되는 API도 광고하고 있어, 기존 애플리케이션에서 로컬 장치로 요청을 보낼 수 있다.
Sipeed의 제품 FAQ는 익숙한 프레임워크가 Axera 하드웨어용으로 작성된 소프트웨어 위에서 작동한다고 설명한다.
SGLang과 vLLM은 AXDSL로 작성된 커널을 사용하는 맞춤형 하드웨어 가속 백엔드를 통해 실행됩니다.
커널은 가속기에서 핵심 계산을 수행하는 작은 소프트웨어 구성 요소다. Sipeed는 지원되는 Hugging Face 모델을 바로 불러올 수 있다고 밝혔다. 반면 새 모델 아키텍처를 지원하려면 AXDSL로 작성된 커널이 필요할 수 있다. 회사는 커널과 개발 도구를 공개하겠다고 약속했으며, AX8860 소프트웨어 개발 키트를 공개하기 위한 작업도 진행 중이라고 밝혔다.
회사는 제품을 켜면 바로 사용할 수 있는 모델과 브라우저 인터페이스를 내세운다. 주요 용도로는 코딩 에이전트, 문서 처리, 동영상 생성, 로보틱스를 제시했다. PCIe 카드는 우선 Linux 호스트를 지원하며, Windows 지원 여부는 수요에 달려 있다. 제품 발표 당시에는 10월 말까지 NPU 툴체인을 제공할 계획이었다.
가격과 배송 일정, 캠페인에 달려
Sipeed가 예상한 128GB 모델의 가격 3,999달러는 6,950달러인 DGX Spark보다 약 2,951달러, 즉 42% 저렴하다. 상당한 할인폭이지만 절반 이하 가격은 아니다. 128GB AMD Ryzen AI Halo의 약 3,999.99달러 가격과도 비슷한 수준이다.
초기에는 2026년 중 제품을 출시할 것으로 예상했지만 이후 일정이 바뀌었다. 예약은 시작됐으나 공식 FAQ는 킥스타터 캠페인을 2026년 말로 잡고 있다. Sipeed는 캠페인 종료 후 3개월 안에 배송하는 것을 목표로 한다고 밝혔다.
- 2026년 10월 13일: Axera가 상하이에서 AX8860 제품군을 공개하고 Sipeed가 MaixStation을 선보였다.
- 2026년 10월 말: Sipeed는 NPU 툴체인을 공개할 것으로 예상했다.
- 2026년 말: Sipeed는 MaixStation 킥스타터 캠페인을 시작할 계획이다.
- 캠페인 종료 후 3개월 이내: Sipeed가 제시한 배송 목표다.
Sipeed는 최종 판매 가격과 확정 배송일, 독립적으로 검증된 MaixStation 성능을 아직 확인하지 않았다. 생산 능력과 지원 체계, 512GB Pro 버전의 가격 및 출시 시점도 정해지지 않았다. 캠페인 기간에 원격 접속과 리뷰용 제품을 제공할 계획이어서, 구매 예정자는 이를 통해 주장을 직접 살펴볼 기회를 얻을 수 있다.
핵심 내용
- MaixStation은 128GB 메모리와 밀집 FP4 기준 256 TOPS 성능의 Axera AX8860P 프로세서를 탑재해 약 3,999달러를 목표로 한다.
- Sipeed는 초당 273GB 메모리 대역폭, 일반적인 소비전력 40와트, 11×11×3cm 크기의 본체를 제시한다.
- 공식 벤치마크 페이지의 절대 속도는 앞서 공개된 범위보다 낮으며, 결과는 모델과 처리 단계에 따라 다르다.
- 소프트웨어 지원은 Axera 맞춤형 가속 백엔드에 의존하며, 개발 도구와 추가 코드를 공개할 계획이다.
- 킥스타터는 2026년 말 시작할 예정이며, 캠페인 종료 후 3개월 이내 배송을 목표로 한다.
- 독립 테스트와 최종 가격, 배송 확정 일정에 따라 Nvidia와 AMD 제품에 대한 경쟁력이 판가름 날 전망이다.