작동하는 GPU와 처리량 5% 우위 주장
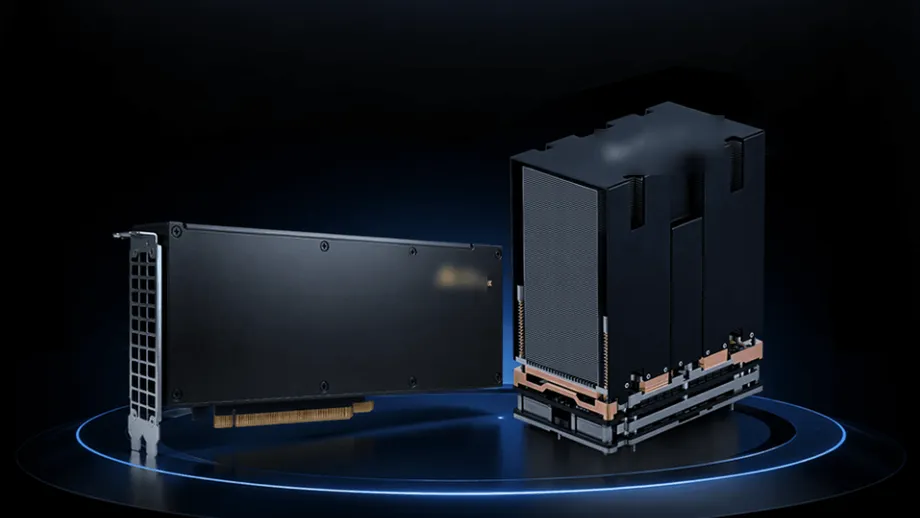
Iluvatar CoreX는 상하이에서 Tiangai 300 그래픽 프로세서를 공개 시연하며 엔비디아 H200의 중국산 대안으로 제시했다. 회사는 제3자 추론 테스트에서 5% 우위를 기록했다고 주장했다. 2026년 10월 28일 열린 미디어 공개 행사에서는 GPU 8개를 탑재한 학습 시스템도 선보였고, GPU 144개와 CPU 18개로 구성된 랙을 소개했다.
목차
Iluvatar CoreX에 따르면 핵심 비교 결과는 상하이전력그룹이 7월 실시한 테스트에서 나왔다. 대규모 언어 모델 처리의 두 단계를 분리한 배포 환경에서 Tiangai 300은 결과를 카드당 수치로 환산했을 때 H200의 1.05배에 해당하는 종단 간 처리량을 달성했다.
처리량은 시스템이 일정 시간 동안 완료하는 유용한 작업의 양을 뜻한다. 챗봇의 경우 초당 생성하는 텍스트의 양을 의미할 수 있다. 기준 성능의 1.05배라는 결과는 해당 테스트 조건에서 출력량이 5% 더 많았다는 뜻이다.
회사는 Tiangai 300이 측정 테스트에서 H200 성능에 도달한 최초의 중국산 범용 GPU라고 설명했다. 10월 시연에서는 비교 대상 작업을 언어 모델, 이미지 생성, 동영상 생성으로 확대했고, 별도의 학습 시연에서는 엔비디아 H100을 기준으로 삼았다.
이번 행사에서는 칩 사양뿐 아니라 카드, 서버, 고밀도 랙 설계, 소프트웨어 도구, 서로 다른 프로세서 유형 간 AI 작업 분담 방식도 선보였다. 회사의 상업적 제안은 이러한 요소를 결합해 대기 시간을 줄이고 비용을 낮추면서 유용한 AI 출력을 제공할 수 있다는 것이다.
H200 비교가 측정하는 것
상하이전력그룹의 7월 테스트에는 흔히 PD 분리라고 줄여 부르는 프리필·디코드 분리 방식이 적용됐다. 프리필은 언어 모델이 사용자의 요청과 관련 자료를 읽는 단계다. 디코드는 토큰을 하나씩 생성해 답변을 만드는 단계다. 토큰은 AI 시스템이 텍스트를 나누는 작은 단위다.
두 단계를 분리하면 읽기와 쓰기에 각각 다른 자원을 배정할 수 있다. 따라서 Tiangai 300 결과는 특정한 배포 구성에서 나온 것이며, 전체 성능은 카드 한 장당 환산 수치로 제시됐다.
Iluvatar CoreX는 핵심 제3자 테스트 결과의 세부 방법, 모델 목록, 작업 부하 조건을 공개하지 않았다. 독립적인 재현을 위해서는 이러한 정보와 환산 계산 방식, 소프트웨어 설정이 필요하다. 비용 비교의 세부 내역도 공개되지 않았으며, 개별 카드와 전체 랙의 메모리 용량 수치도 명확한 설명이 필요하다.
성능 연구소가 공개한 시연 결과는 회사 주장의 구체적인 면을 보여준다. 멀티미디어 생성의 소폭 향상부터 추천 처리량의 더 큰 증가까지 작업별로 개선 폭이 다르다. 구매자가 주목할 비교 기준은 자사 서비스에서 실제로 수행하는 작업이다.
긴 문서 처리와 더 빠른 첫 응답
회사 연구소에 따르면 Tiangai 300의 어텐션 성능은 컨텍스트 길이 64K에서 H200의 1.05배에 달했다. 어텐션은 모델이 입력의 어떤 부분들이 서로 관련 있는지 파악하도록 돕는 처리 과정이다. 컨텍스트 길이 64K는 모델이 약 6만4,000개 토큰을 처리한다는 뜻이다.
같은 컨텍스트 규모에서 GLM-5.3을 구동했을 때 Iluvatar CoreX는 동등한 사용자 경험을 유지하면서 H200의 1.15배에 해당하는 처리량을 기록했다고 주장했다. 테스트한 전문가 혼합형 작업 부하에서 15% 증가한 수치다. 전문가 혼합 모델은 토큰마다 모든 네트워크를 사용하는 대신 선택된 전문 네트워크에 작업을 배분한다.
컨텍스트 길이가 8K~128K인 AI 에이전트 작업에서는 첫 출력 토큰이 나올 때까지의 대기 시간이 약 10~30% 줄었다고 회사는 밝혔다. 이 수치는 긴 문서를 읽거나 복잡한 요청을 처리한 뒤 보조 도구가 답변을 시작하기를 기다리는 사용자에게 중요하다.
이미지 및 동영상 생성도 시연의 일부였다. 회사는 H200과 비교해 멀티모달 생성 처리량이 약 2~5% 증가했다고 밝혔다. 온라인 검색, 광고, 추천 작업에서는 추천 추론 처리량이 21% 높아지고 경량 연산 지연 시간은 26% 낮아졌다고 주장했다.
학습 결과는 다른 엔비디아 제품을 기준으로 삼아
학습 시연에서는 약 320억 개의 매개변수를 가진 모델인 Qwen3-32B를 GPU 8개가 탑재된 서버에서 구동했다. 매개변수는 모델이 패턴을 학습하기 위해 훈련 과정에서 조정하는 수치다. Iluvatar CoreX는 카드당 유효 처리량이 엔비디아 H100의 1.33배에 달했다고 밝혔다.
따라서 해당 학습 시연에서 H100 대비 보고된 성능 우위는 33%다. 행사에서 다른 추론 결과의 기준으로 삼은 제품은 H200이었다. 수치를 이해하려면 이 기준 제품들을 구분하는 것이 중요하다.
학습 시스템은 FP8 정밀도로 작동했다. FP8은 8비트로 수를 저장해 더 많은 비트를 사용하는 형식보다 이동·처리해야 하는 데이터의 양을 줄인다. AI 학습 소프트웨어는 학습 품질을 유지할 수 있도록 낮은 정밀도를 신중하게 관리해야 한다.
Iluvatar CoreX는 최대 부하로 장시간 작동할 때 스텝 시간 변동률이 0.43%로, Hopper 기반 기준 시스템의 0.76%보다 낮았다고 밝혔다. 스텝 시간은 반복 작업 단위를 완료하는 데 걸리는 시간이다. 시간 변동이 작으면 운영자가 시스템이 바쁜 동안 처리할 작업량을 계획하는 데 도움이 될 수 있다.
7월 출시에서 10월 시연까지
Tiangai 300은 2026년 7월 세계인공지능대회에서 정식 공개됐다. 회사의 Tianshu 아키텍처를 사용하며, 차세대 텐서 코어를 탑재하고 그래픽 메모리 용량은 144GB로 제시됐다.
프로세서는 스칼라, 벡터, 텐서 연산을 지원한다. 쉽게 말해 각각 개별 수, 숫자 묶음, 더 큰 수학적 배열을 처리한다. 지원하는 수치 형식은 FP4, FP8, FP16, BF16이며, 소프트웨어 개발자는 속도, 메모리 사용량, 수치 정밀도에 따라 선택할 수 있다.
회사가 공개한 주요 일정은 수개월에 걸쳐 이어졌다.
- 2026년 7월: 세계인공지능대회에서 Tiangai 300 출시.
- 2026년 7월: 상하이전력그룹, H200 처리량 비교에 인용된 제3자 테스트 완료.
- 10월 미디어 행사 전: 중국국제산업박람회에서 IXL144 랙 설계 공개.
- 2026년 10월 28일: Iluvatar CoreX, 상하이에서 Tiangai 300 하드웨어 실시간 시연을 미디어에 공개.
10월 행사는 제품 소개의 초점을 아키텍처 발표에서 실제 작업을 구동하는 시스템으로 옮겼다. 회사가 설명한 배포 범위는 이제 개별 가속기 카드부터 카드 8개를 탑재한 서버, 더 큰 규모의 IXL144 시스템까지 확대됐다.
GPU 144개를 탑재한 랙
Iluvatar CoreX에 따르면 IXL144는 표준 랙 하나에 GPU 144개와 CPU 18개를 결합하며, GPU 메모리 총용량은 약 10.1TB다. 회사는 이를 단일 랙에 수용된 업계 최고 밀도의 GPU 슈퍼노드라고 소개했다. 슈퍼노드는 대규모 작업을 함께 처리할 수 있도록 여러 프로세서를 긴밀하게 연결한 시스템이다.
Tiangai 300 한 장당 144GB라는 사양과 랙 전체 10.1TB라는 용량을 이해하려면 구성을 더 명확히 설명할 필요가 있다. 용량 계산 방식의 차이를 고려하기 전에도 카드 144장에 144GB씩 곱하면 20,736GB가 된다. 랙 설명에는 카드 구성과 작업에 실제로 사용할 수 있는 메모리 용량이 명시돼야 한다.
Iluvatar CoreX는 이 시스템이 주류 해외 시스템에 비해 유효 토큰 100만 개당 비용을 약 40% 낮출 수 있다고 추산했다. 유효 토큰은 유용한 작업으로 집계되는 출력을 뜻한다. AI 서비스를 판매하는 운영자에게 이 지표는 하드웨어 비용과 실제 사용 가능한 출력량을 연결해 준다.
비용이 40% 줄어든다면 기준 시스템에서 100단위가 드는 작업을 60단위에 수행한다는 뜻이다. 실제 절감액은 장비 가격, 전력 사용량, 소프트웨어, 작업 부하, GPU의 가동률에 따라 달라진다.
회사는 차세대 피어 투 피어 연결 엔진의 목표도 제시했다. 연결 도메인 내 단일 전송 시간을 3~5마이크로초에서 1마이크로초로 줄이는 것이다. 서로 다른 GPU가 모델의 각기 다른 부분을 보유하고 데이터를 반복해서 주고받아야 할 때 통신 속도가 빨라지면 도움이 된다.
서로 다른 칩에 AI 작업을 분배
Iluvatar CoreX의 이종 배포 방식은 추론의 각 부분을 서로 다른 프로세서 유형에 배정한다. AFD 분리 방식에서 Tiangai 300은 프리필 단계 전체와 디코딩 중 어텐션 연산을 담당한다. 파트너사의 XPU는 피드포워드 전문가 네트워크를 처리한다.
XPU는 다른 유형의 컴퓨팅 가속기를 폭넓게 가리키는 용어다. 기본 개념은 각 프로세서가 가장 잘 처리하는 작업을 맡기고 공통 스케줄러가 전체 작업을 조율하는 것이다. 피드포워드 네트워크는 언어 모델 내부의 주요 수학 연산 중 또 다른 부분을 수행한다.
회사는 통합 스케줄링을 적용했을 때 디코딩 추론 지연 시간이 60% 감소했다고 밝혔다. 이는 H200보다 처리량이 5% 높다는 핵심 결과와는 별도의 시스템 구성과 성능 지표다.
회사의 AI·가속 컴퓨팅 책임자인 Shan Tianyi는 미래의 AI 컴퓨팅 시스템은 모든 작업에 한 종류의 프로세서만 의존하는 대신 서로 다른 칩을 효율적으로 구성하는 데 달려 있을 것이라고 말했다. AFD 시연은 GPU와 파트너 가속기를 구체적으로 조합해 이 전략을 구현한 사례다.
배포 시간 단축을 내세운 소프트웨어
Iluvatar CoreX는 배포와 최적화의 일부를 자동화하기 위한 AI 기반 AI 소프트웨어 스택도 선보였다. 회사는 환경 설정 작업 시간이 1시간에서 10분으로 줄고 수십 가지에 달했던 수동 작업이 한 가지로 감소했다고 밝혔다.
대규모 모델 최적화 작업의 경우 작업 기간을 7일에서 2시간 미만으로 단축하고 성능을 기존의 약 두 배 수준으로 끌어올렸다고 회사는 보고했다. 이러한 사례는 하드웨어에서 모델을 효율적으로 실행하기 위해 필요한 엔지니어링 작업에 관한 것이다.
회사는 GPU 연산 루틴 개발에 쓰이는 언어인 FlyDSL과의 긴밀한 통합도 주장했다. 컴파일 속도가 90% 이상 개선됐으며, 기존에는 10명이 하루 동안 해야 했던 작업을 한 사람이 몇 시간 안에 완료하는 작업 흐름을 구현했다고 설명했다.
프로세서에는 성능 좋은 연산 하드웨어만 필요한 것이 아니므로 소프트웨어 지원도 중요하다. 모델, 수학 라이브러리, 배포 도구가 함께 작동해야 한다. 소프트웨어 시연은 고객이 새 GPU를 실제 서비스에 활용하기까지 얼마나 많은 엔지니어링 작업이 필요한지 보여준다.
로봇으로 영역을 넓히는 TY1200
상하이 행사에서는 AI PC와 피지컬 인텔리전스, 즉 물리적 세계를 인식하고 행동하는 로봇 등을 겨냥한 별도 프로세서 Tongyang TY1200도 소개됐다. 명시된 고밀도 연산 성능은 300 TOPS, 즉 초당 300조 회 연산이다. 고밀도 연산은 0값과 관련된 계산을 건너뛰지 않고 계산량을 집계한다.
Iluvatar CoreX는 Qwen3.8-27B와 Qwen3.6-35B-A3B를 활용한 테스트에서 TY1200이 엔비디아 Thor T5000 성능의 1.2배를 기록했다고 주장했다. 피지컬 AI 시나리오에서 Cosmos-R2-2B와 Cosmos-R2-8B 모델을 구동한 결과는 각각 Thor T5000 기준 성능의 158%, 180%에 달했다고 밝혔다.
회사는 TY1200이 MuJoCo-Warp를 사용한 GPU 가속 물리 시뮬레이션도 구동할 수 있다고 밝혔다. 이를 통해 로봇 개발 시스템은 움직임을 시뮬레이션하고 제어 정책을 학습하며 동작을 로컬에서 점검할 수 있다. 제어 정책은 로봇이 움직임을 결정할 때 사용하는 학습된 지침의 집합이다.
보고된 적용 분야로는 의료 방문 시 사람을 돕는 로봇, 산업용 비전, 방문객 안내 등이 있다. 후속 제품으로 계획된 TY2000의 연산 성능 목표는 600T다. 이들 제품은 대형 AI 서버를 넘어 사용자와 기계 가까이에서 작동하는 장비로 회사의 전략을 확장한다.
핵심 내용
- Iluvatar CoreX는 2026년 10월 28일 상하이에서 Tiangai 300 하드웨어를 시연했다.
- 회사는 상하이전력그룹의 테스트 결과를 인용해 카드당 처리량이 엔비디아 H200의 1.05배에 해당한다고 밝혔다.
- GPU 8개를 사용한 Qwen3-32B 학습 시연에서는 FP8 정밀도로 카드당 H100의 1.33배에 해당하는 처리량을 기록했다고 보고했다.
- 핵심 제3자 벤치마크의 세부 방법은 공개되지 않았다.
- IXL144 랙에는 GPU 144개와 CPU 18개가 탑재되며, 유효 토큰 100만 개당 비용을 40% 낮춘다고 주장했다.
- GPU와 XPU에 작업을 나눠 맡기는 별도 배포 방식에서는 디코딩 지연 시간이 60% 줄었다고 보고했다.
- 행사에서는 소프트웨어 자동화와 로컬 AI, 로봇 시뮬레이션에 적용되는 TY1200도 다뤘다.